1018 hPa
53 %

23 °C
Скопје - Пет, 11.09.2026 09:00
1018 hPa
53 %
23 °C
Скопје - Пет, 11.09.2026 09:00

Според Cloudflare, во 2026 година автоматизираните системи создаваат околу 57% од веб-барањата.
За првпат, машините создаваат повеќе веб-барања од луѓето.
Со години постоеше едноставен непишан договор меѓу Google и сопствениците на веб-страници: Google ја индексира нивната содржина, а за возврат им испраќа посетители преку пребарувачот. Од таа размена корист имаа двете страни. Google изгради убедливо најмоќен пребарувач, а милиони медиуми, блогови, форуми и независни автори добиваа публика.
Денес содржините од милиони веб-страници не служат само за класично пребарување. Тие се користат и за создавање одговори преку AI Overviews, AI Mode и други системи базирани на вештачка интелигенција. Наместо список со извори што треба да ги посети, корисникот сè почесто добива готов одговор директно од Google. Информацијата потекнува од вебот, но посетата на веб-страницата сè почесто изостанува.
Токму тука критиките кон Google стануваат посериозни. Компанијата со децении ја градеше својата доминација нудејќи им на веб-страниците видливост и посетители во замена за пристап до нивната содржина. Денес истата содржина може да послужи за создавање AI-одговор што ја намалува потребата корисникот воопшто да го посети оригиналниот извор. Google така од посредник што носеше публика постепено станува и конкурент на оние што ја создаваат информацијата.
Тоа е особено проблематично поради огромната позиција што Google веќе ја има на пазарот на интернет-пребарување. За повеќето издавачи едноставното блокирање на Googlebot не е реална опција: исчезнувањето или полошата видливост во Google Search може да значи губење значителен дел од публиката. Истовремено, истиот систем за собирање содржини се користи и во новиот свет на AI. Издавачите така се доведени во незгодна позиција: тешко можат да кажат „не“ на AI без да ризикуваат нешто што им е неопходно за опстанок на класичниот веб.
Проблемот не е само прашање на авторски права. Станува збор и за економијата на интернетот. Новинарите, фотографите, истражувачите, блогерите и безброј други автори вложуваат време и пари за да создадат нешто ново. Ако машините потоа го прочитаат, сумираат и прераскажат тоа дело, а корисникот повеќе нема причина да стигне до оригиналниот извор, се губи економската логика врз која со децении функционираше голем дел од отворениот интернет.
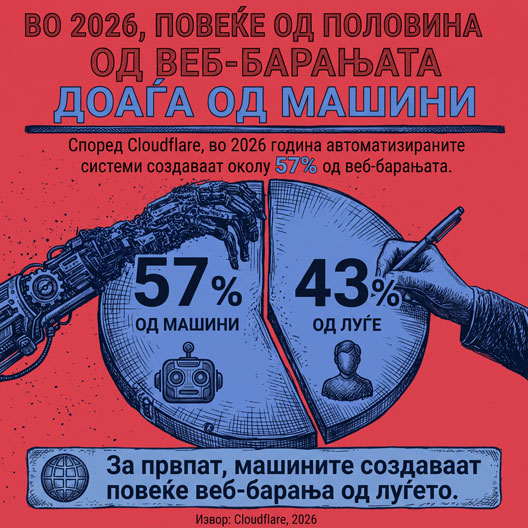
Промената веќе може да се види и во самиот интернет-сообраќај. Според Cloudflare, во 2026 година автоматизираните системи создаваат околу 57 проценти од веб-барањата, со што машинскиот сообраќај за првпат го надмина човечкиот. Шефот на Cloudflare, Метју Принс, предупредува дека разликата во следните години може дополнително да расте.
Тој посочува и на уште една голема нерамнотежа. Според податоците на Cloudflare, Googlebot има пристап до значително поголем дел од вебот од роботите на конкурентските AI-компании. Тоа само по себе не е чудно: Google го гради својот индекс повеќе од две децении. Проблемот е што инфраструктурата создадена за пребарување сега претставува огромна предност и во трката за вештачка интелигенција.
Со други зборови, Google располага со нешто што неговите AI-конкуренти никогаш го немале: пристап што милиони веб-страници доброволно му го дале за една цел - да бидат пронајдени преку пребарувач - а кој сега може да се користи и за сосема поинаков производ. Тешко е таквата промена да се смета за сосема фер ако сопствениците на содржината немаат едноставен начин да ги раздвојат двете работи.
Отпорот веќе започна. Cloudflare, чија инфраструктура опслужува огромен дел од светскиот веб, бара појасно раздвојување на роботите што индексираат за пребарување од оние што собираат содржини за AI. Идејата е едноставна: веб-страницата да може да му дозволи на Google да ја индексира за Search, но истовремено да каже дека не дозволува нејзината содржина да се користи за создавање AI-одговори.
Притисок стигна и од британската Competition and Markets Authority. Регулаторот побара сопствениците на веб-страници да добијат јасен избор дали нивната содржина ќе се користи во генеративните AI-функции на Google, без поради таквата одлука да бидат казнети со полоша позиција во класичните резултати од пребарувањето.
Google веќе тестира нови контроли со кои сопствениците на страници ќе можат подобро да управуваат со користењето на нивната содржина во AI Overviews и AI Mode. Тоа е важна промена, но останува прашањето зошто ваквиот избор не постоеше од самиот почеток.
Најчистото решение би било технички да се раздвојат двете функции: еден робот за класично индексирање и друг за AI. Тогаш секој сопственик на веб-страница би можел сам да одлучи дали сака да учествува во пребарувачот, во AI-системите или во двете. Тоа би било многу порамноправен однос отколку сопствениците на содржини едноставно да мораат да му веруваат на Google дека нивниот избор ќе биде почитуван.
Прашањето, сепак, е поголемо и од Google. Ако интернетот постепено стане место на кое машините главно читаат содржини создадени од луѓе, ги преработуваат и им ги сервираат на корисниците без тие да стигнат до оригиналните извори, кој ќе има економска причина да продолжи да создава нова содржина?
Тука лежи и парадоксот на сегашниот развој на вештачката интелигенција. AI зависи токму од она што потенцијално го загрозува: интернет исполнет со нови текстови, фотографии, истражувања, искуства и идеи создадени од луѓе.
Проблемот, значи, не е што машините го читаат интернетот. Проблемот настанува кога компанијата што ја контролира главната врата кон интернетот истовремено одлучува како ќе ја користи содржината зад таа врата - и притоа има економски интерес корисникот што подолго да остане кај неа, наместо да стигне до оној што ја создал информацијата.




Ние пред три години направивме сликовница за прво, второ и трето одделение што се вика ‘Јас, мама, тато, дада и бато‘. Оттука порака за првачињата: освен тоа што ќе побараат да стекнат знаење, можеби треба да побараат да стекнат и братче и сестриче.
Весна Јаневска, министерка за образование, на првиот училиштен ден во училиштето „Ацо Шопов“ во Општина Бутел; СДК, 01.09.26.
Македонска делегација прашала еден Јапонец:
– Како стигнавте до тоа ниво целата нација да ви биде паметна?
Јапонецот одговорил:
– Многу нации се попаметни од нас. Кај повеќето нации деветмина се паметни, а еден е глуп. Кај нас, во Јапонија, деветмина се глупи, а еден е паметен. Разликата е во тоа што ние му дозволуваме на тој еден паметен да ги води деветте будали. Кај вас, пак, будалата ги води деветте паметни.



Алек Букарски во „#Антианархистички манифест“ низ тринаесет фрагментарни, автобиографски и алегориски текстови ја испишува мапата на личните и општествените противречности на современа Македонија. Меѓу анархизмот и припадноста, провинцијата и главниот град, интимното и политичкото, оваа книга е немирен запис за осаменоста, идентитетот и потрагата по слобода.

Списанието за култура „Маргина” #95 е број посветен на попреченоста.